Każde usunięcie wpisu, ukrycie filmu czy zawieszenie konta na dużej platformie w Unii Europejskiej zostawia ślad w publicznej bazie Komisji Europejskiej. Bazę może przeszukać każdy, bez logowania i bez wiedzy programistycznej.
Poniżej pokazujemy, co dokładnie w niej jest, jak ustawić filtry, jak pobrać dane i jakie pytania o Polskę da się jej zadać. Wszystkie liczby sprawdziliśmy sami w bazie 11 października 2026 r. i opisujemy, jak je powtórzyć.
W skrócie
- Baza przejrzystości DSA (ang. DSA Transparency Database) gromadzi uzasadnienia decyzji moderacyjnych platform internetowych. Komisja Europejska prowadzi ją od 25 września 2023 r., co podaje strona Komisji o przejrzystości w akcie o usługach cyfrowych.
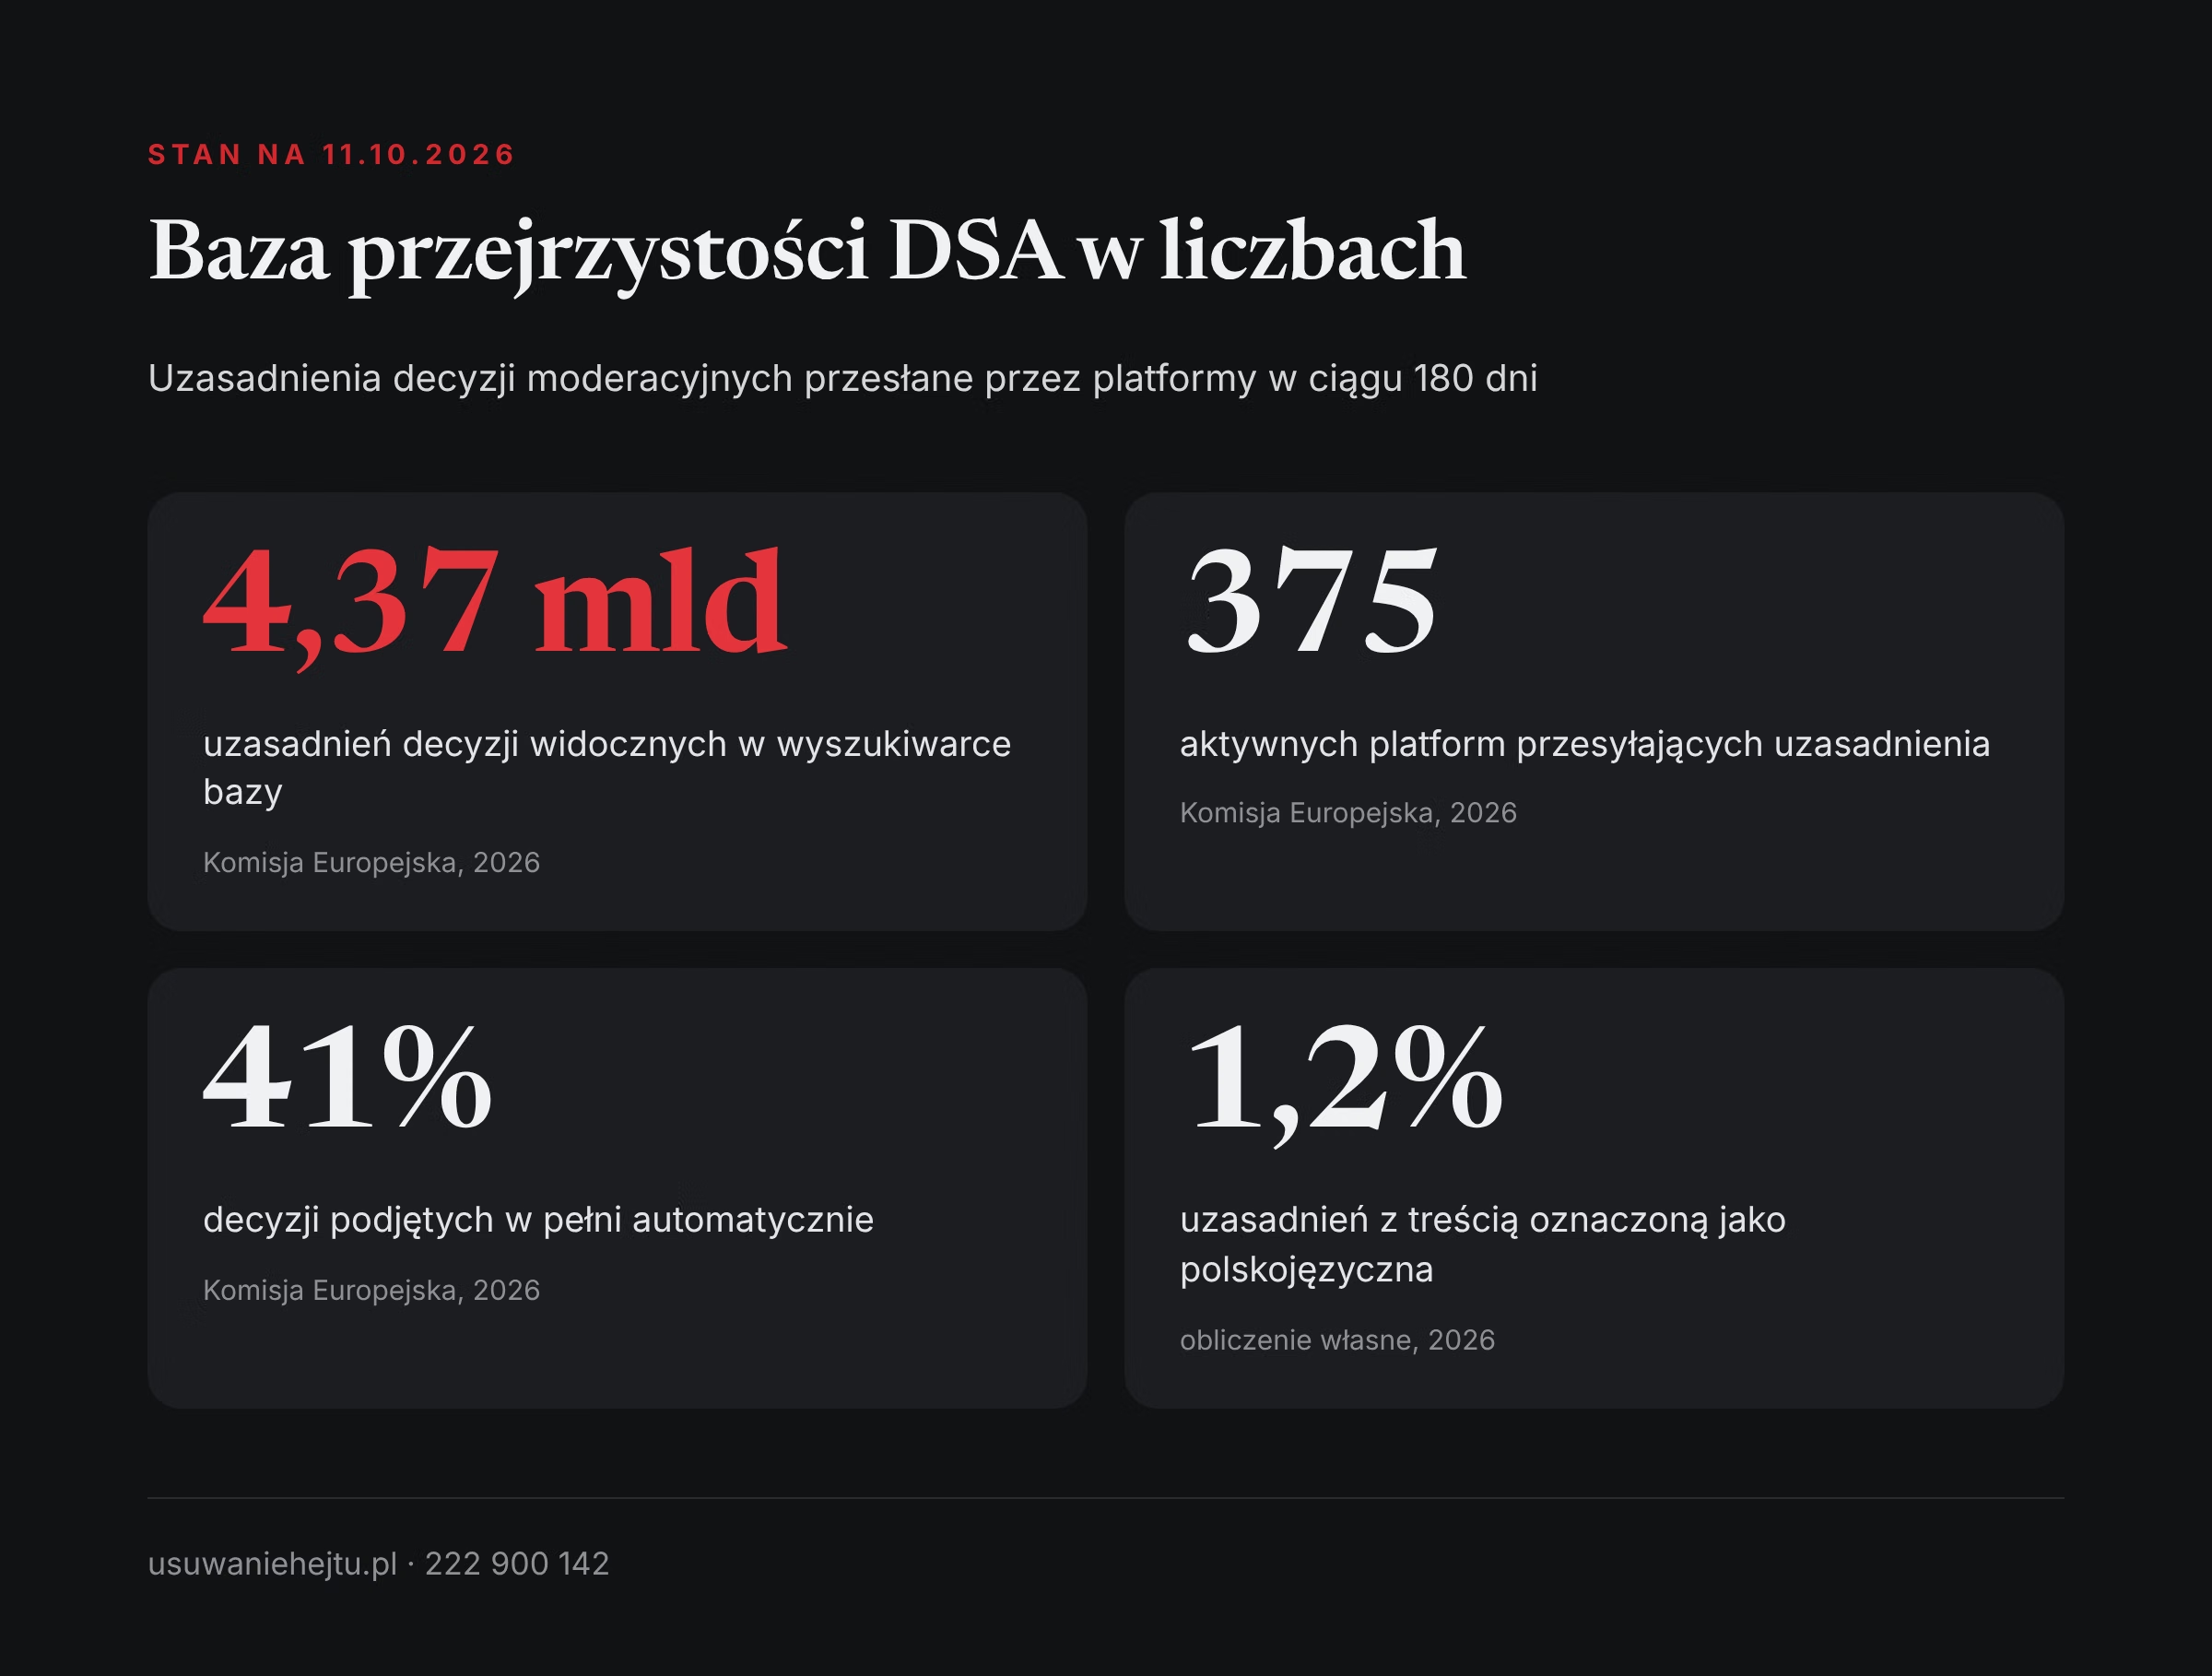
- W wyszukiwarce widać ostatnie 180 dni. 11 października 2026 r. było to 4 365 565 491 uzasadnień, a strona główna bazy podawała 375 aktywnych platform i 41% decyzji w pełni zautomatyzowanych.
- Do pracy służą cztery narzędzia: panel z wykresami, wyszukiwarka z filtrami, dzienne pliki do pobrania i interfejs badawczy. Każde ma inny zasięg czasowy i inne limity.
- Filtr „Polska” w polu zasięgu terytorialnego nie oznacza „decyzji o polskich treściach”. Zwrócił 3 471 179 805 rekordów, czyli około 80% całej bazy, bo obejmuje też decyzje wydane dla całej Unii.
- Język polski oznaczono w 53 842 066 uzasadnieniach (około 1,2%). Pole języka jest nieobowiązkowe i w 1 945 783 787 rekordach pozostało puste.
- Baza nie zawiera samych treści, danych osobowych ani informacji o zgłoszeniach, które platforma odrzuciła. Dane wpisują platformy i zdarzają się w nich błędy.
Czym jest baza przejrzystości DSA i skąd biorą się w niej dane?
DSA to unijny akt o usługach cyfrowych (ang. Digital Services Act). Jego art. 17 każe dostawcom usług hostingowych wyjaśnić użytkownikowi, dlaczego usunęli lub ograniczyli jego treść. Takie wyjaśnienie to uzasadnienie decyzji (ang. statement of reasons).
Art. 24 ust. 5 idzie krok dalej. Platformy internetowe, czyli między innymi serwisy społecznościowe, sklepy z aplikacjami i platformy handlowe, muszą przesyłać wszystkie swoje uzasadnienia do bazy Komisji. Opisuje to zestaw pytań i odpowiedzi Komisji Europejskiej o bazie.
Kto wpisuje dane.
Rekordy tworzą same platformy, przez interfejs programistyczny albo formularz. Komisja udostępnia bazę i pilnuje jej spójności, ale nie ocenia pojedynczych decyzji.
Kto może z niej korzystać.
Każdy. Przeglądanie, wyszukiwanie i pobieranie plików nie wymaga konta. Logowanie przez konto EU Login jest potrzebne tylko do interfejsu badawczego i do formularza opinii.
Na jakiej licencji.
Według informacji o licencji danych treści należące do Unii są udostępniane na licencji Creative Commons Uznanie autorstwa 4.0. Wolno je wykorzystywać, także w publikacjach, pod warunkiem podania źródła i zaznaczenia zmian.
Ten tekst opisuje narzędzie i przepisy w ogólnym zakresie. Nie zastępuje porady prawnika w konkretnej sprawie.
Co zawiera jedno uzasadnienie decyzji?
Każdy rekord ma tę samą budowę. Plik pobrany z wyszukiwarki 11 października 2026 r. miał 38 kolumn. Ich znaczenie wyjaśnia dokumentacja bazy. Najważniejsze grupy pól wyglądają tak.
Rodzaj ograniczenia
Platforma zaznacza co najmniej jeden z czterech rodzajów ograniczeń: widoczności treści, wypłat pieniędzy, świadczenia usługi albo konta. Przy widoczności do wyboru jest między innymi usunięcie treści, zablokowanie dostępu, obniżenie pozycji, ograniczenie wiekowe i oznaczenie etykietą.
Jedno uzasadnienie może łączyć kilka ograniczeń. Wpis może zostać usunięty, a konto autora zawieszone na trzy miesiące. Każde ograniczenie ma wtedy własną datę końcową. Brak daty końcowej oznacza ograniczenie bezterminowe.
Podstawa decyzji
Pole podstawy (decision_ground) ma dwie wartości: treść nielegalna albo treść niezgodna z regulaminem serwisu. To jedno z najważniejszych pól dla badacza, bo pokazuje, czy platforma powołała się na prawo, czy na własne zasady.
W praktyce prawie wszystko opiera się na regulaminach. W ciągu 180 dni przed 11 października 2026 r. podstawę „treść nielegalna” wskazano w 9 279 864 uzasadnieniach, co daje około 0,2% wszystkich rekordów widocznych w wyszukiwarce uzasadnień (obliczenie własne).
Kategoria naruszenia
Platforma musi wybrać jedną główną kategorię z zamkniętej listy. Wyszukiwarka pokazuje 16 kategorii, między innymi „Illegal or harmful speech” (nielegalna lub szkodliwa mowa), „Cyber violence” (przemoc w sieci), „Data protection and privacy violations” (naruszenia ochrony danych i prywatności), „Protection of minors” (ochrona małoletnich) oraz „Scams and/or fraud” (oszustwa).
Do kategorii można dodać słowa kluczowe, które ją doprecyzowują. Dla osób zajmujących się hejtem najciekawsze są: „Defamation” (zniesławienie), „Discrimination” (dyskryminacja), mowa nienawiści oznaczona jako „hate speech”, „Cyber bullying and intimidation” (nękanie i zastraszanie w sieci), „Cyber harassment” (uporczywe nękanie) oraz „Cyber stalking” (śledzenie i osaczanie w sieci). Słowa kluczowe są nieobowiązkowe, więc wiele rekordów ich nie ma.
Źródło sprawy i automatyzacja
Pole źródła (source_type) mówi, co uruchomiło decyzję: zgłoszenie złożone w trybie art. 16 DSA, zgłoszenie zaufanego podmiotu sygnalizującego, inne powiadomienie albo własna inicjatywa platformy. O tym, kim są takie podmioty, piszemy w tekście o zaufanych podmiotach sygnalizujących.
Dwa kolejne pola dotyczą automatów. Pierwsze informuje, czy treść wykrył automat. Drugie, czy samą decyzję podjęto w pełni automatycznie, częściowo automatycznie czy bez udziału automatu.
Treść, język, kraj i daty
Rekord podaje rodzaj treści (tekst, obraz, film, dźwięk, produkt, aplikacja, media syntetyczne lub inne), datę jej powstania, datę zastosowania ograniczenia i datę przesłania uzasadnienia do bazy. Jest też zasięg terytorialny, czyli lista państw, w których ograniczenie działa: 27 państw Unii oraz Islandia, Liechtenstein i Norwegia.
Pole języka treści jest opcjonalne. To drobiazg z dużymi skutkami, do którego wrócimy przy zapytaniach o Polskę.
Czego w rekordzie nie ma
Samej treści.
Baza zawiera opis decyzji, a nie usunięty wpis, zdjęcie czy film. Nie ma też adresu, pod którym treść była dostępna.
Danych osobowych.
Platformy mają obowiązek usunąć je przed wysyłką. Jeśli mimo to traficie w polu opisowym na czyjeś dane, można to zgłosić Komisji funkcją „Report an issue” (zgłoś problem).
Informacji o odwołaniu.
Pouczenie o środkach odwoławczych trafia tylko do adresata decyzji. Z bazy nie dowiecie się, czy ktoś się odwołał i z jakim skutkiem.
Cztery narzędzia: które wybrać?
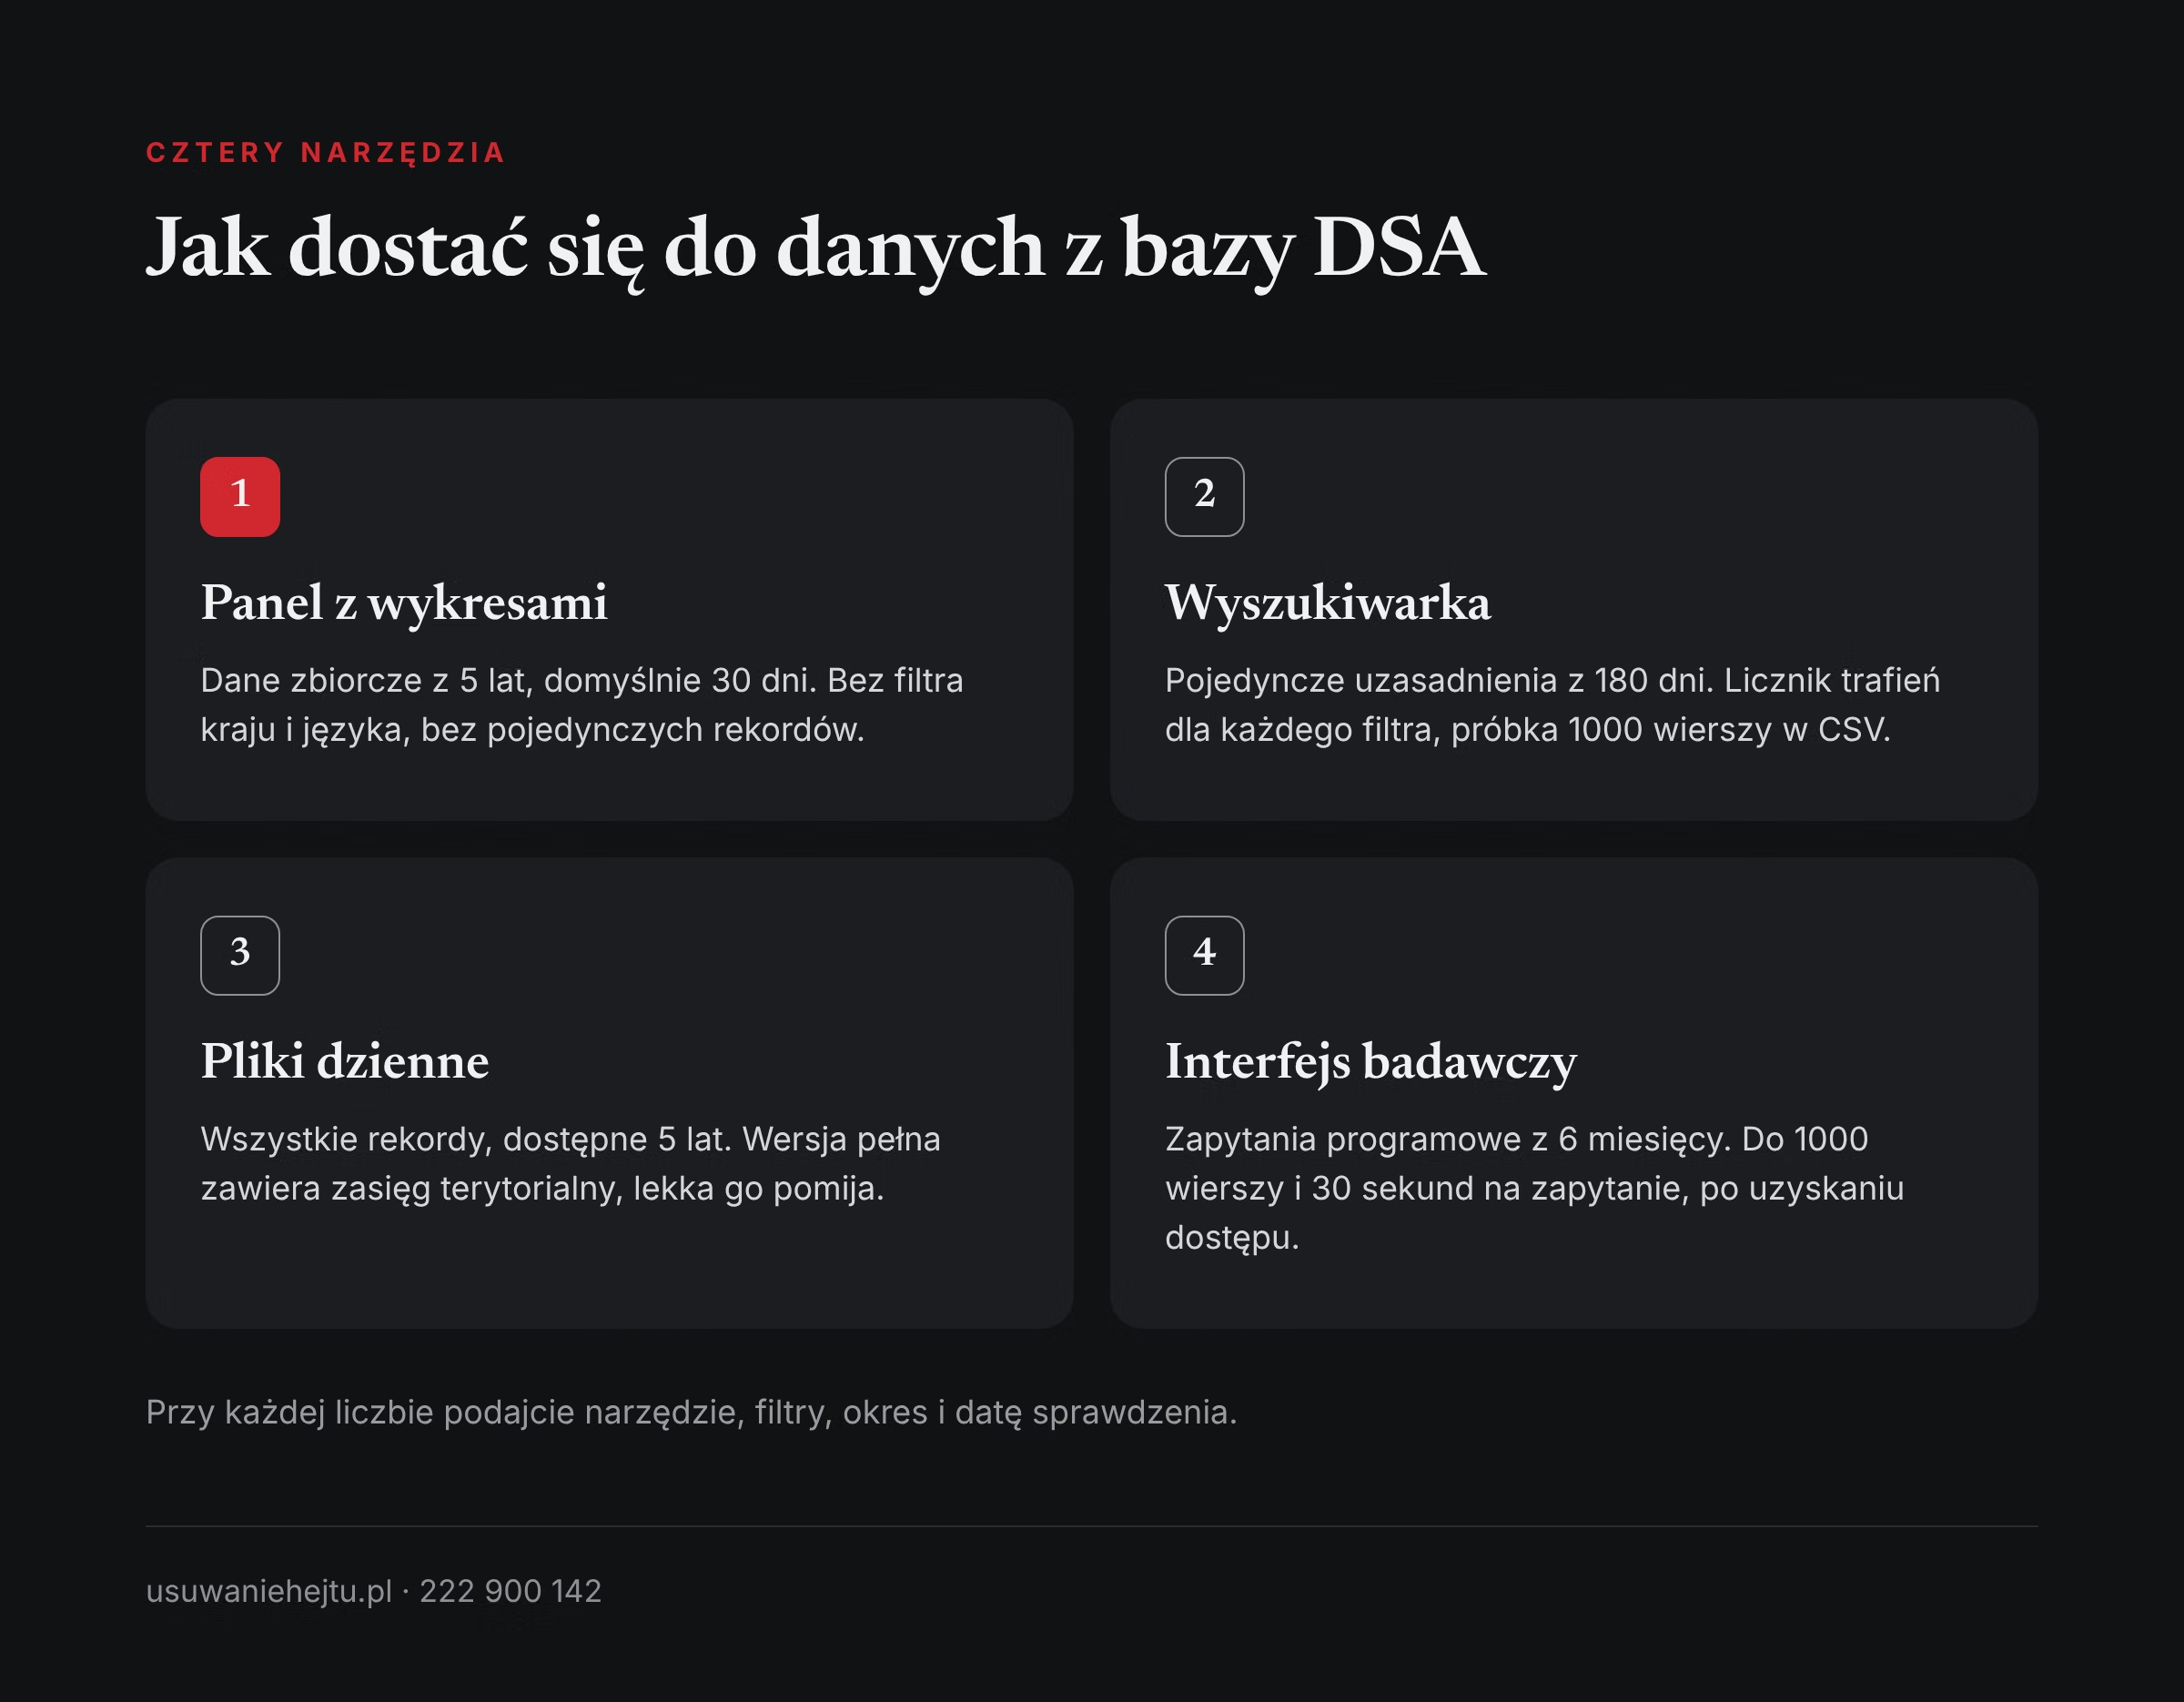
Komisja udostępnia cztery sposoby pracy z danymi. Różnią się zasięgiem czasowym, limitem wyników i wymaganą wiedzą techniczną. Zestawienie opiera się na przeglądzie narzędzi na stronie bazy i na polityce przechowywania danych w wersji 2.0, obowiązującej od 18 lutego 2025 r.
| Narzędzie | Zasięg czasowy | Najważniejszy limit | Dla kogo |
|---|---|---|---|
| Panel (Dashboard) | ostatnie 5 lat, domyślnie 30 dni | tylko dane zbiorcze, bez filtra kraju i języka | osoby bez umiejętności programowania |
| Wyszukiwarka uzasadnień | ostatnie 180 dni | przeglądanie do 10 000 wyników, eksport 1000 do pliku CSV | dziennikarze, studenci, nauczyciele |
| Pliki dzienne | 5 lat od utworzenia pliku | bardzo duży rozmiar, od 5 MB do 5 GB dziennie zależnie od pliku | badacze pracujący z dużymi zbiorami |
| Interfejs badawczy (Research API) | ostatnie 6 miesięcy | 1000 wierszy na zapytanie, 30 sekund, 5 MB odpowiedzi | osoby programujące, po uzyskaniu dostępu |
Źródło: DSA transparency database, Explore data overview, polityka przechowywania danych oraz dokumentacja Research API. Stan na 11 października 2026 r.
Warto zapamiętać jedną zmianę. Starsze opisy podają, że pliki dzienne są dostępne przez 18 miesięcy. Od 18 lutego 2025 r. okres ten wydłużono do 5 lat. Po tym czasie pliki trafiają do archiwum Komisji.
Jak korzystać z panelu z wykresami?
Panel bazy to najszybsza droga do ogólnego obrazu. Dane odświeżają się codziennie o godzinie 6:00 czasu środkowoeuropejskiego. Domyślnie widać ostatnie 30 dni.
- Otwórzcie panel i poczekajcie, aż załadują się wykresy.
- Rozwińcie menu filtrów, oznaczone trzema poziomymi liniami w lewym górnym rogu panelu.
- Wybierzcie platformę lub kilka platform, zakres dat, rodzaj naruszenia albo rodzaj ograniczenia. Kilka pozycji naraz zaznaczycie z wciśniętym klawiszem Ctrl.
- Przechodźcie między stronami u dołu panelu. Jest ich sześć: przegląd platform, przegląd ograniczeń i naruszeń, osie czasu, analiza naruszeń, analiza ograniczeń oraz pozostałe analizy.
- Aby zobaczyć dokładne liczby, użyjcie prawego przycisku myszy na wykresie i opcji „Show as a table” (pokaż jako tabelę).
Ograniczenie, o którym trzeba wiedzieć.
Panel nie ma filtra państwa ani języka. Komisja pisze o tym wprost w pytaniach i odpowiedziach i odsyła po takie analizy do plików dziennych. Z panelu nie pobierzecie też pojedynczych uzasadnień.
Dlaczego liczby w panelu i w wyszukiwarce się różnią.
Panel sięga dalej w przeszłość niż wyszukiwarka. Przy tych samych filtrach oba narzędzia mogą więc pokazać inne wartości. W tekście zawsze podawajcie, z którego narzędzia pochodzi liczba i jakiego okresu dotyczy.
Jeszcze jedna pułapka dotyczy nazw. Od 1 lipca 2025 r. obowiązuje nowy schemat bazy z innymi nazwami kategorii. Starsze rekordy panel pokazuje według dawnego nazewnictwa, a tabelę odpowiedników udostępnia Komisja.
Jak wyszukać uzasadnienia krok po kroku?
Wyszukiwarka pokazuje pojedyncze rekordy z ostatnich 180 dni i podaje liczbę trafień dla każdego zestawu filtrów. To najlepsze narzędzie do szybkiego sprawdzenia hipotezy.
- Wejdźcie na stronę „Search for statements of reasons”.
- W polu „Platform” wybierzcie serwis lub kilka serwisów. Nie wpisujcie nazwy platformy w pole wyszukiwania tekstowego, bo ono przeszukuje tylko pola opisowe uzasadnień.
- Rozwińcie „Advanced filter” (filtr zaawansowany).
- Ustawcie potrzebne filtry: podstawę decyzji, źródło, kategorię, słowo kluczowe, rodzaj ograniczenia, rodzaj konta, rodzaj treści, język, zasięg terytorialny i automatyzację.
- W polach „Created starting” i „Created ending” podajcie zakres dat przesłania uzasadnienia do bazy.
- Zatwierdźcie opcją „Show results” (pokaż wyniki). Nad tabelą pojawi się wiersz „Statements of reasons” z liczbą trafień.
- Otwórzcie dowolny wiersz, żeby zobaczyć pełne uzasadnienie ze wszystkimi polami.
- Jeśli potrzebujecie próbki, użyjcie odnośnika „Download a sample of 1000 results in CSV”. Plik otworzy się w arkuszu kalkulacyjnym.
Limit przeglądania.
Strony wyników obejmują tylko pierwsze 10 000 rekordów, a eksport pierwsze 1000. Liczba trafień nad tabelą dotyczy jednak całego zbioru. Do policzenia czegoś wystarczy więc sam licznik.
Adres strony zapisuje filtry.
Po zatwierdzeniu filtry trafiają do adresu w przeglądarce, na przykład w postaci content_language[]=PL albo territorial_scope[]=PL. Skopiujcie ten adres do notatek. Dzięki temu Wy albo redaktor sprawdzający tekst powtórzycie zapytanie jednym otwarciem strony.
Zapisujcie datę.
Okno 180 dni przesuwa się codziennie, więc to samo zapytanie za tydzień da inny wynik. Przy każdej liczbie notujcie dzień sprawdzenia.
Jak pobrać dane z bazy?
Próbka z wyszukiwarki
To najprostsza droga. Plik ma do 1000 wierszy i 38 kolumn. Część pól, na przykład rodzaj ograniczenia i zasięg terytorialny, zapisano jako listy w nawiasach kwadratowych. Przy liczeniu w arkuszu trzeba to uwzględnić.
Pamiętajcie, że próbka to najnowsze rekordy, a nie losowy wycinek. Nie wolno z niej wyciągać wniosków o proporcjach w całej bazie.
Pliki dzienne
Na stronie pobierania danych każdy dzień ma osobne archiwum. Można pobrać wszystkie platformy razem albo jedną wybraną. 11 października 2026 r. lista obejmowała 1111 dni.
Wersja pełna i wersja lekka.
Wersja pełna (full) zawiera wszystkie pola. Wersja lekka (light) pomija trzy najdłuższe pola opisowe oraz pole zasięgu terytorialnego. Kto bada Polskę, potrzebuje więc wersji pełnej.
Rozmiar.
Plik zbiorczy z 9 października 2026 r. zawierał 24 907 447 uzasadnień. Wersja pełna zajmowała 1,56 GB w archiwum i 24,91 GB po rozpakowaniu, a lekka odpowiednio 1,14 GB i 9,60 GB. Arkusz kalkulacyjny tego nie otworzy.
Budowa archiwum.
Archiwum dnia zawiera kolejne archiwa, a w nich pliki CSV po około 100 000 wierszy. Do każdego pliku dołączona jest suma kontrolna SHA1, która pozwala sprawdzić, czy pobieranie się udało.
Jeśli interesuje Was jeden serwis, zacznijcie od pliku tej platformy. Pliki pojedynczych, mniejszych serwisów są wielokrotnie mniejsze od pliku zbiorczego.
Gotowe dane zbiorcze i pakiet dsa-tdb
Komisja publikuje też dzienne zestawienia zbiorcze w formatach CSV i Parquet. Są dwa warianty: podstawowy, ten sam, który zasila panel, oraz rozszerzony, liczony według wszystkich pól poza opisowymi. To dobry kompromis, gdy potrzebujecie liczb, a nie pojedynczych rekordów.
Do pracy z plikami służy otwarty pakiet dsa-tdb w języku Python. Według dokumentacji pakietu dsa-tdb w październiku 2024 r. przechowanie wszystkich pobranych plików dziennych wymagało co najmniej 4,1 TB miejsca na dysku, a dzienny przyrost danych wynosił od 5 do 10 GB. Od tamtej pory baza urosła.
Interfejs badawczy
Research API pozwala zadawać zapytania programowo. Dostęp wymaga konta EU Login i prośby o token wysłanej do zespołu wsparcia Komisji. Interfejs obejmuje ostatnie 6 miesięcy i służy do analiz statystycznych, a nie do masowego pobierania rekordów.
Jakie pytania o Polskę da się zadać bazie?
Tu zaczynają się schody. Baza nie ma pola „kraj użytkownika” ani „kraj treści”. Są dwa pola, które pozwalają zbliżyć się do Polski: język treści i zasięg terytorialny. Każde mierzy coś innego i każde ma poważną wadę.
Zasięg terytorialny: dlaczego „PL” to nie Polska
Zaznaczenie Polski w polu „Territorial scope” zwraca wszystkie decyzje, które obowiązują także w Polsce. Większość z nich obowiązuje w całej Unii. 11 października 2026 r. taki filtr dał 3 471 179 805 rekordów na 4 365 565 491 wszystkich, czyli około 80% (obliczenie własne).
Liczby z tym filtrem mówią więc: „tyle decyzji objęło również Polskę”. Nie mówią: „tyle decyzji dotyczyło polskich użytkowników”. Decyzje ograniczone wyłącznie do Polski da się wydzielić dopiero w pobranych plikach w wersji pełnej, gdzie widać całą listę państw.
Język treści: mały i przechylony wycinek
Filtr „Content language: Polish” zwrócił 53 842 066 uzasadnień. To około 1,2% bazy. W 1 945 783 787 rekordach, czyli w blisko 45%, języka nie podano w ogóle.
Co ważniejsze, 53 662 271 z polskojęzycznych rekordów, czyli ponad 99%, przesłała jedna usługa: porównywarka ofert Google Shopping. Te same zapytania dla Facebooka, Instagrama, TikToka, YouTube’a i serwisu X z filtrem języka polskiego zwróciły zero wyników. Największe serwisy społecznościowe w badanym okresie po prostu nie wypełniały pola języka dla polskich treści.
Wniosek jest prosty. Filtr języka polskiego nie nadaje się do zdań w rodzaju „tyle polskich wpisów usunięto za hejt”. Nadaje się do pokazania, jak mało wiadomo o języku moderowanych treści.
Przykładowe zapytania i ich wyniki
Wszystkie wyniki pochodzą z wyszukiwarki uzasadnień, obejmują 180 dni poprzedzających 11 października 2026 r. i dają się powtórzyć po ustawieniu tych samych filtrów.
| Pytanie | Filtry | Liczba uzasadnień |
|---|---|---|
| Ile decyzji objęło także Polskę? | zasięg terytorialny: PL | 3 471 179 805 |
| Ile z nich oparto na nielegalności treści? | zasięg: PL, podstawa: treść nielegalna | 2 649 790 |
| Ile dotyczyło nielegalnej lub szkodliwej mowy? | zasięg: PL, kategoria: Illegal or harmful speech | 45 080 315 |
| Ile dotyczyło przemocy w sieci? | zasięg: PL, kategoria: Cyber violence | 9 775 320 |
| Ile dotyczyło prywatności i danych? | zasięg: PL, kategoria: Data protection and privacy violations | 21 796 801 |
| Ile dotyczyło ochrony małoletnich? | zasięg: PL, kategoria: Protection of minors | 6 465 007 |
| Ile oznaczono słowem kluczowym mowy nienawiści? | zasięg: PL, słowo kluczowe: hate speech | 8 174 668 |
| Ile oznaczono słowem kluczowym nękania w sieci? | zasięg: PL, słowo kluczowe: Cyber bullying and intimidation | 217 098 |
| Ile oznaczono słowem kluczowym zniesławienia? | zasięg: PL, słowo kluczowe: Defamation | 4 372 |
| Ile zaczęło się od zaufanego podmiotu sygnalizującego? | zasięg: PL, źródło: trusted flagger | 6 996 |
| Ile dotyczyło treści oznaczonych jako polskojęzyczne? | język: polski | 53 842 066 |
| Ile polskojęzycznych dotyczyło nielegalnej lub szkodliwej mowy? | język: polski, kategoria: Illegal or harmful speech | 674 |
Źródło: DSA transparency database, Search for statements of reasons, zapytania własne z 11 października 2026 r.
Jak czytać te wyniki?
Kategorie „z zasięgiem PL” są niemal równe unijnym.
W całej bazie kategorię nielegalnej lub szkodliwej mowy wskazano 46 382 528 razy, a z zasięgiem obejmującym Polskę 45 080 315 razy. Przy przemocy w sieci było to 10 029 243 i 9 775 320. Około 97% takich decyzji obowiązuje więc także w Polsce, bo platformy stosują je w całej Unii.
Zniesławienie prawie nie występuje.
Słowo kluczowe „Defamation” pojawiło się w 4 372 rekordach obejmujących Polskę. Nie znaczy to, że zniesławień jest mało. Znaczy, że platformy rzadko używają tego nieobowiązkowego oznaczenia i wolą ogólne kategorie regulaminowe.
Zaufane podmioty to ułamek całości.
W całej bazie zgłoszenie zaufanego podmiotu było źródłem 25 381 decyzji, z czego 6 996 objęło Polskę. Wśród treści oznaczonych jako polskojęzyczne nie było ani jednej takiej decyzji.
674 rekordy to nie obraz polskiego hejtu.
Pobraliśmy wszystkie 674 polskojęzyczne uzasadnienia z kategorii nielegalnej lub szkodliwej mowy. Pochodziły z sześciu usług, wśród których nie było żadnego z największych serwisów społecznościowych. 517 decyzji podjęto w pełni automatycznie, a 480 obowiązywało we wszystkich 30 państwach.
Jeśli chcecie porównać te dane z tym, co serwisy same ogłaszają, zajrzyjcie do naszych zestawień: ile opinii usuwają serwisy z recenzjami oraz ile fałszywych kont i przypadków nękania usuwa LinkedIn.
Które platformy przesyłają najwięcej uzasadnień?
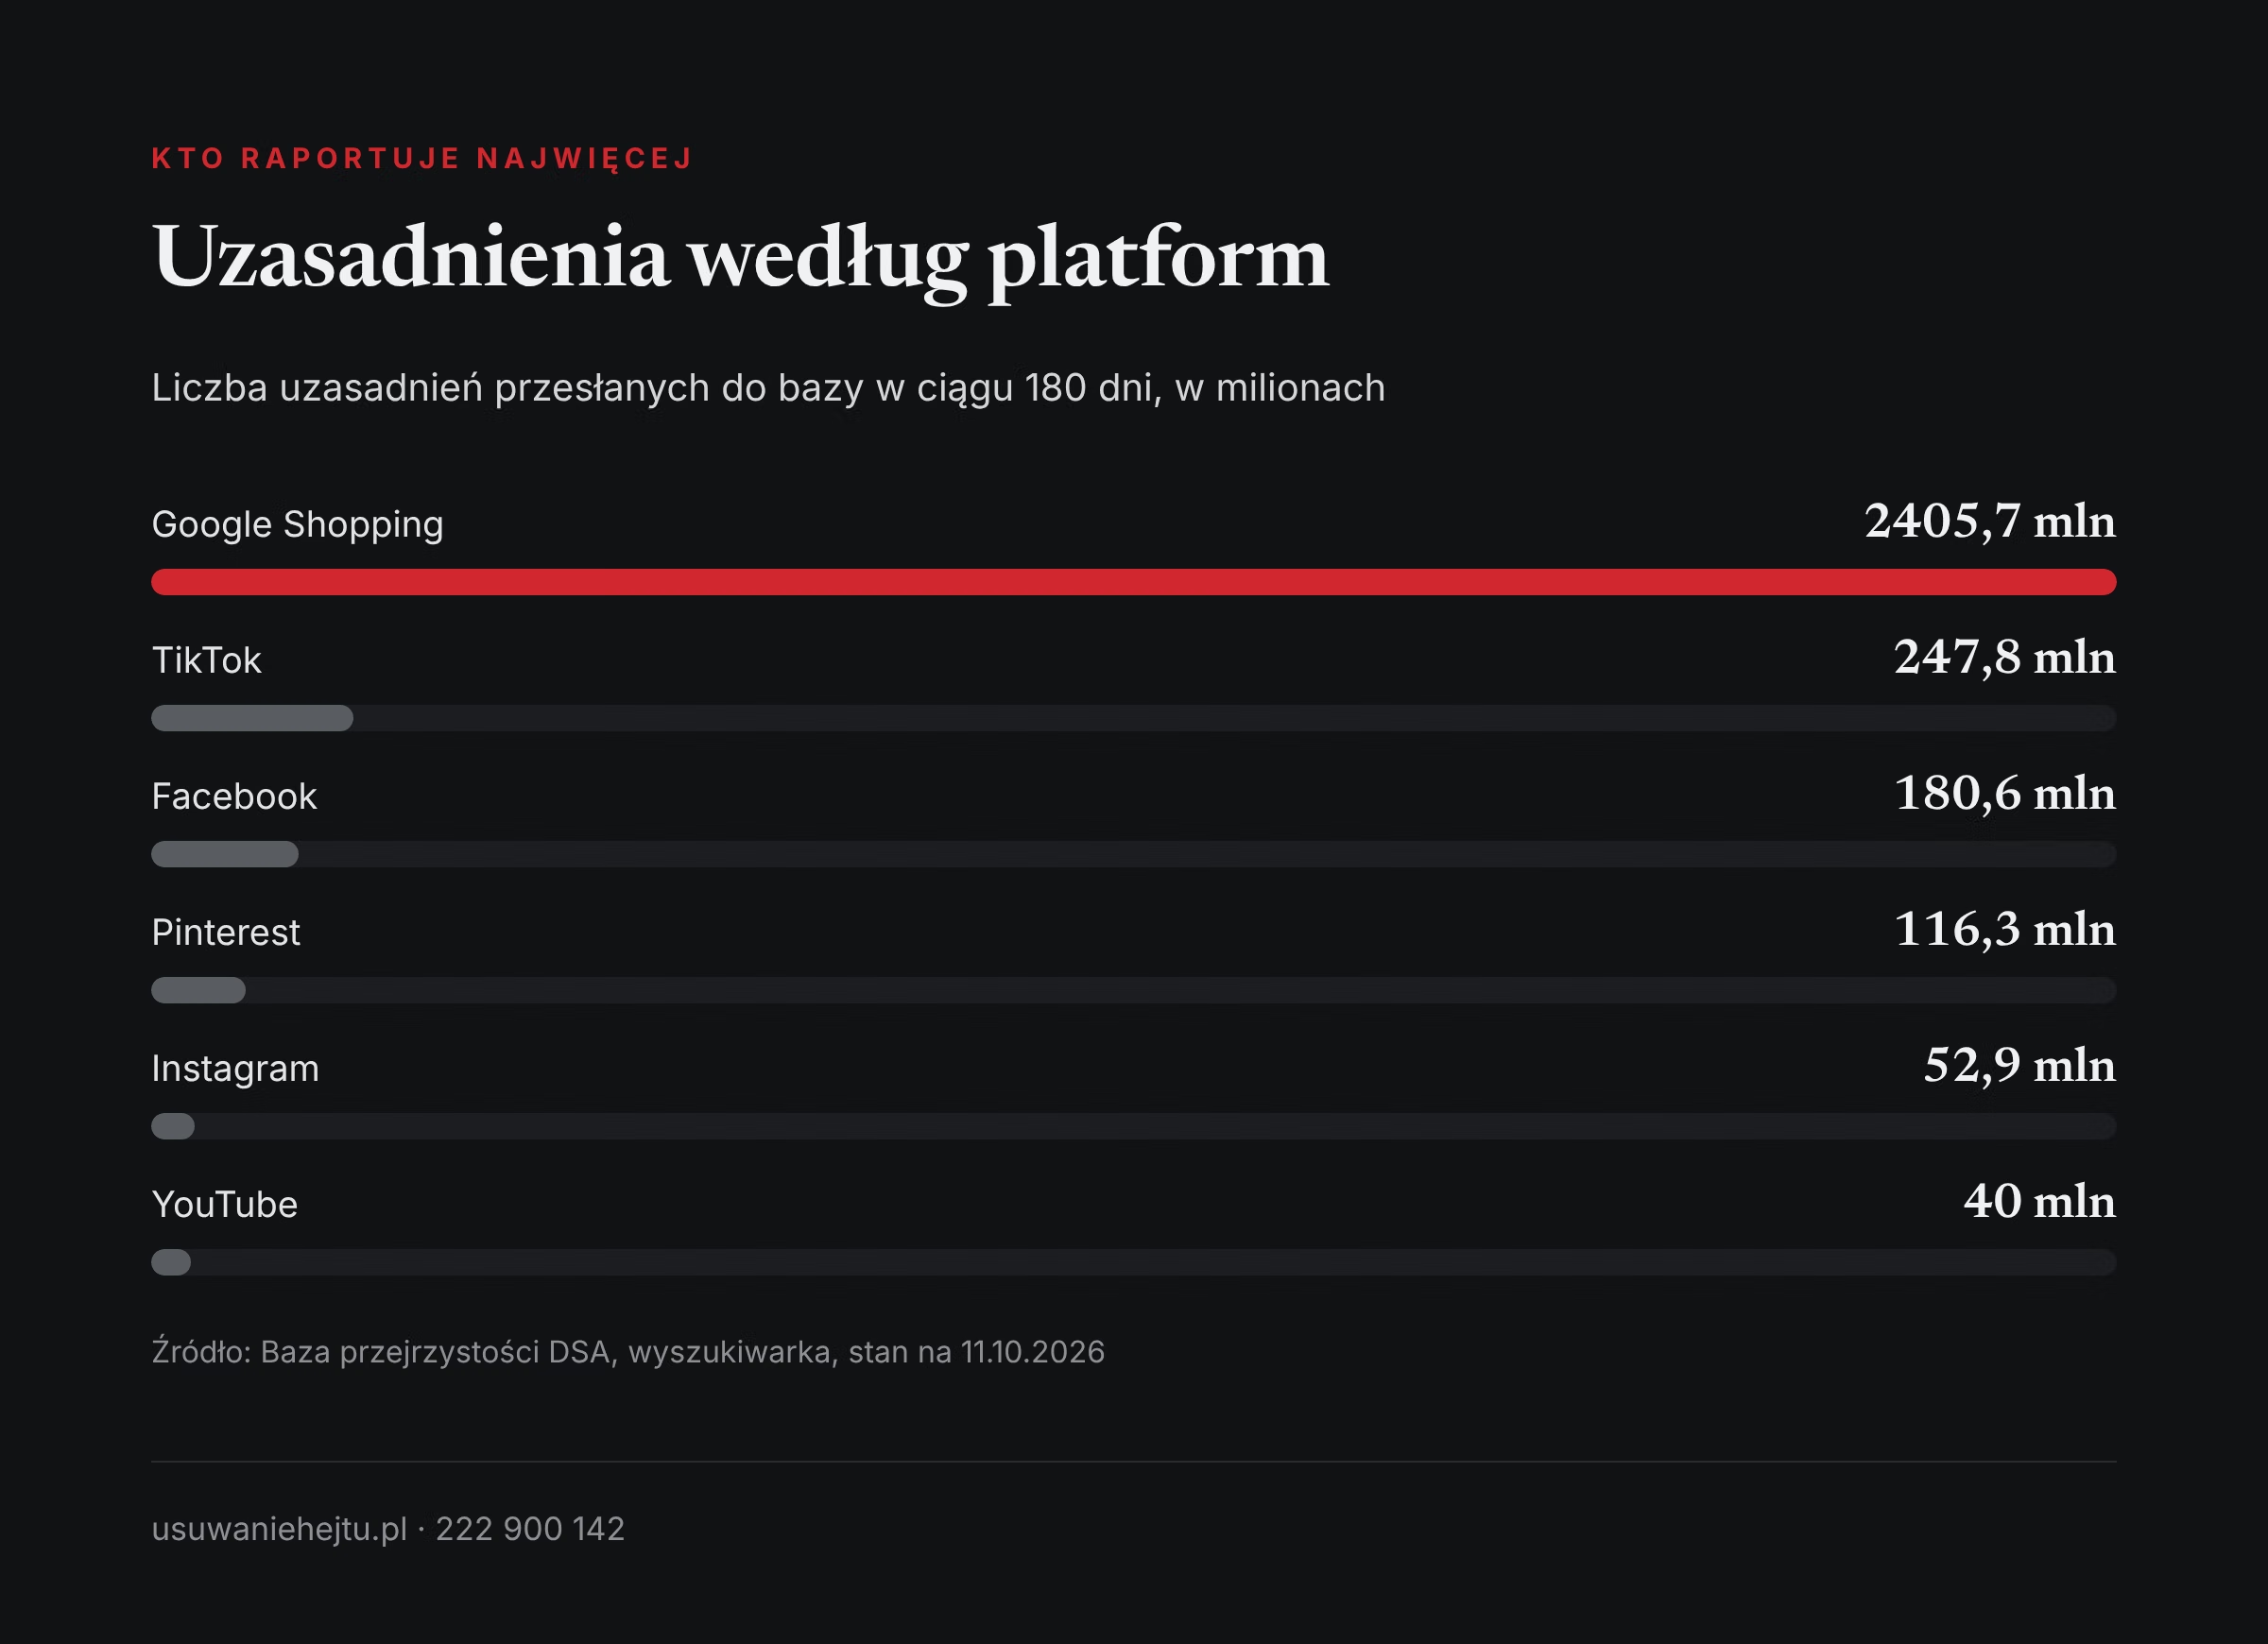
Baza jest zdominowana przez handel, a nie przez serwisy społecznościowe. Na stronie głównej jako najczęstsze naruszenia wymieniono: inne naruszenia regulaminu, produkty niebezpieczne lub zakazane oraz naruszenia informacji konsumenckich.
| Platforma | Uzasadnienia z 180 dni | Udział w bazie |
|---|---|---|
| Google Shopping | 2 405 740 724 | 55,1% |
| TikTok | 247 848 829 | 5,7% |
| 180 554 379 | 4,1% | |
| 116 291 358 | 2,7% | |
| 52 904 117 | 1,2% | |
| YouTube | 40 006 942 | 0,9% |
| Snapchat | 2 693 783 | 0,06% |
| X | 2 638 026 | 0,06% |
| 379 471 | 0,01% | |
| OLX | 186 452 | poniżej 0,01% |
Źródło: DSA transparency database, Search for statements of reasons, filtr „Platform”, stan na 11 października 2026 r. Udziały to obliczenia własne względem 4 365 565 491 rekordów.
Tych liczb nie wolno czytać jak rankingu surowości. Platformy różnią się liczbą użytkowników, rodzajem treści i tym, co uznają za jedną decyzję. Sklep internetowy raportuje każdą wstrzymaną ofertę, a serwis społecznościowy każdy usunięty komentarz.
Na liście 375 platform jest niewiele serwisów kojarzonych z Polską. Wiele polskich portali, forów i serwisów z opiniami w ogóle w niej nie występuje. Jeżeli Wasza sprawa dotyczy takiego miejsca, baza niewiele o nim powie.
Czego baza nie pokaże? Ograniczenia danych
To najważniejsza część dla każdego, kto chce cytować bazę. Dane są cenne, ale mają granice wynikające z metody.
Dane wpisują same platformy.
Nikt nie weryfikuje każdego rekordu. Komisja publikuje komunikaty o zmianach i błędach w bazie. W czerwcu 2026 r. poinformowała, że w części rekordów jednego ze sklepów z aplikacjami pole wykrycia automatycznego było odwrócone od września 2023 r. do maja 2026 r. W listopadzie 2025 r. podała, że uzasadnienia dwóch dużych serwisów społecznościowych oparte na zgłoszeniach zaufanych podmiotów mogły nie być tak oznaczone przed 28 października 2025 r.
Baza widzi tylko decyzje ograniczające.
Uzasadnienie powstaje, gdy platforma coś usuwa albo ogranicza. Jeśli zgłosiliście hejt, a serwis odpowiedział, że treść nie narusza zasad, w bazie nie ma po tym śladu. Baza nie pokaże więc, jak często zgłoszenia są odrzucane ani ile trwa ich rozpatrzenie.
Nie widać, co stało się potem.
Nie ma informacji o odwołaniach, przywróconych treściach ani o sprawach skierowanych do sądu lub organów.
Jedna kategoria główna spłaszcza obraz.
Wpis, który jest jednocześnie groźbą, zniesławieniem i naruszeniem prywatności, trafi do jednej kategorii wybranej przez platformę. Strona główna bazy jako najczęstszą wymienia ogólną kategorię „inne naruszenie regulaminu”.
Schemat zmienił się 1 lipca 2025 r.
Starsze rekordy mają inne kategorie. Porównania sprzed i po tej dacie wymagają tabeli odpowiedników. W maju i czerwcu 2024 r. Komisja usuwała też zdublowane i błędne rekordy, co obniżyło wcześniejsze sumy.
Okno 180 dni.
Wyszukiwarka i interfejs badawczy nie sięgają dalej. Trendy wieloletnie wymagają panelu albo plików dziennych.
Na jakość danych zwracają uwagę także badacze. Autorzy analizy „The DSA Transparency Database: Auditing Self-reported Moderation Actions by Social Media” przebadali 353,12 mln rekordów przesłanych przez osiem największych serwisów społecznościowych w pierwszych 100 dniach działania bazy, czyli od września 2023 r. Stwierdzili, że znaczna część danych jest niespójna, a platformy tylko częściowo trzymały się założeń bazy.
Drugi zespół, w pracy „Automated Transparency: A Legal and Empirical Analysis of the Digital Services Act Transparency Database”, przeanalizował próbę 131 mln uzasadnień z listopada 2023 r. Wniosek był podobny: struktura bazy zostawia platformom dużą swobodę w tym, jak raportują.
Nasze własne zapytania też mają ograniczenia. Pokazują jeden dzień, jedno narzędzie i okno 180 dni. Nie obejmują decyzji starszych, nie rozdzielają decyzji wydanych tylko dla Polski i nie mówią nic o treściach, których język nie został oznaczony.
Jak powoływać się na bazę w tekście lub pracy naukowej?
Dobre zdanie oparte na bazie zawiera cztery elementy: narzędzie, filtry, okres i datę sprawdzenia. Przykład: „Według wyszukiwarki bazy przejrzystości DSA w ciągu 180 dni przed 11 października 2026 r. platformy przesłały 9 775 320 uzasadnień z kategorii przemocy w sieci, których zasięg obejmował Polskę”.
Unikajcie skrótów myślowych.
Zdanie „w Polsce usunięto 9,8 mln hejterskich wpisów” byłoby nieprawdziwe z trzech powodów. Zasięg obejmujący Polskę to nie to samo co polska treść. Ograniczenie to nie zawsze usunięcie. Kategoria to wybór platformy, a nie ocena sądu.
Podawajcie formułę cytowania.
Komisja prosi o przywoływanie bazy w brzmieniu: European Commission-DG CONNECT, Digital Services Act transparency database, Directorate-General for Communications Networks, Content and Technology, 2023, z identyfikatorem https://doi.org/10.2906/134353607485211.
Zachowajcie ślad.
Zapiszcie adres zapytania, zrzut ekranu z licznikiem i pobraną próbkę. Jeśli ktoś zakwestionuje liczbę, pokażecie, skąd pochodzi.
Dla szkoły baza może być dobrym ćwiczeniem z krytycznego czytania danych. Uczniowie mogą sprawdzić, które serwisy raportują najwięcej decyzji, a potem zestawić to z własnym doświadczeniem. Jak zebrać takie doświadczenia w klasie, opisujemy w tekście o ankiecie o hejcie i cyberprzemocy w szkole.
Czy w bazie znajdę decyzję we własnej sprawie?
Raczej nie. Rekordy nie zawierają nazwy konta, adresu treści ani jej fragmentów. Mają wewnętrzny identyfikator nadany przez platformę, ale zna go tylko ona.
Jeśli to Waszą treść ograniczono, pełne uzasadnienie powinniście dostać bezpośrednio od serwisu, razem z informacją o możliwości odwołania. Jak pisać takie odwołanie, pokazujemy na przykładzie w tekście o zawieszonym koncie na X.
Jeśli to Wy zgłaszaliście cudzą treść, baza też nie potwierdzi wyniku. Odpowiedź przychodzi w powiadomieniu od serwisu. Sposoby zgłaszania opisujemy osobno dla Facebooka i Messengera, dla TikToka i Instagrama oraz dla YouTube’a.
Baza przydaje się w takiej sprawie pośrednio. Pokazuje, że dany serwis faktycznie ogranicza treści z określonej kategorii i jak często robi to automatycznie. To argument, gdy słyszycie, że „nic się nie da zrobić”.
Podsumowanie: jak pracować z bazą, żeby nie wyciągnąć fałszywych wniosków
Unijna baza decyzji moderacyjnych to największy publiczny zbiór danych o tym, co platformy usuwają i ograniczają. W ciągu 180 dni trafia do niej ponad 4 miliardy uzasadnień, a każdy może je przeszukać i pobrać.
Do szybkiego sprawdzenia liczby wystarczy wyszukiwarka z filtrami. Do trendów służy panel. Do rzetelnych badań o Polsce potrzebne są pełne pliki dzienne, bo tylko w nich widać dokładną listę państw objętych decyzją.
Najczęstszy błąd to utożsamianie filtra „PL” z Polską. Drugi to wnioskowanie z pola języka, które duże serwisy społecznościowe zostawiają puste. Trzeci to zapominanie, że baza nie widzi zgłoszeń odrzuconych.
Mimo tych ograniczeń baza daje coś, czego wcześniej nie było: możliwość samodzielnego sprawdzenia deklaracji platform. Warto z niej korzystać, podając zawsze narzędzie, filtry, okres i datę.
Gdzie szukać pomocy?
Z pytaniami o samą bazę można zwrócić się do Komisji Europejskiej przez formularz opinii na stronie bazy. Wymaga on konta EU Login. Skargi na to, jak platforma stosuje akt o usługach cyfrowych, przyjmuje krajowy koordynator do spraw usług cyfrowych.
Jeśli za Waszym zainteresowaniem bazą stoi konkretna sprawa hejtu, pomoże Fundacja Usuwanie Hejtu. Pomagamy przygotować zgłoszenia do serwisów i prowadzimy je do końca, pomagamy zabezpieczyć materiał oraz kierujemy do prawnika lub psychologa. Kontakt: tel. 222 900 142, biuro@usuwaniehejtu.pl. Działania Fundacji można wesprzeć darowizną na stronie usuwaniehejtu.pl.
Gdy hejt odbiera siły, warto porozmawiać z kimś od razu. Dorośli w kryzysie emocjonalnym mogą zadzwonić pod numer 116 123, dzieci i młodzież pod 116 111, a rodzice i nauczyciele pod 800 100 100. W razie zagrożenia życia dzwońcie pod 112.
Najczęściej zadawane pytania
1. Co to jest baza przejrzystości DSA?
To publiczna baza Komisji Europejskiej, do której platformy internetowe przesyłają uzasadnienia swoich decyzji o usunięciu lub ograniczeniu treści i kont. Działa od 25 września 2023 r. na podstawie aktu o usługach cyfrowych.
2. Czy korzystanie z bazy wymaga konta lub opłaty?
Nie. Panel, wyszukiwarka i pliki do pobrania są otwarte dla każdego bez logowania i bez opłat. Konto EU Login jest potrzebne tylko do interfejsu badawczego i formularza opinii.
3. Czy baza jest dostępna po polsku?
Interfejs bazy jest w języku angielskim. Nazwy filtrów i kategorii warto przepisać dokładnie, bo od nich zależy wynik. Ogólny opis bazy po polsku znajduje się na stronie Komisji o przejrzystości w akcie o usługach cyfrowych.
4. Czy w bazie zobaczę usunięty wpis albo film?
Nie. Baza zawiera wyłącznie opis decyzji: rodzaj ograniczenia, podstawę, kategorię, daty i informacje o automatyzacji. Samej treści, jej adresu ani danych autora w niej nie ma.
5. Jak sprawdzić, ile decyzji dotyczyło Polski?
Wprost się nie da, bo baza nie ma pola kraju użytkownika. Filtr zasięgu terytorialnego pokazuje decyzje obowiązujące także w Polsce, w większości ogólnounijne. Decyzje wydane tylko dla Polski trzeba wydzielić z pełnych plików dziennych.
6. Dlaczego filtr języka polskiego daje tak mało wyników?
Pole języka jest nieobowiązkowe i wiele platform go nie wypełnia. W październiku 2026 r. ponad 99% rekordów oznaczonych jako polskojęzyczne pochodziło z jednej porównywarki ofert, a największe serwisy społecznościowe nie miały ani jednego.
7. Jak daleko wstecz sięga wyszukiwarka?
Obejmuje 180 dni od przesłania uzasadnienia. Starsze rekordy pozostają w plikach dziennych przez 5 lat od utworzenia pliku i nadal zasilają panel z wykresami.
8. Ile wyników można pobrać z wyszukiwarki?
Jednorazowo do 1000 najnowszych rekordów w pliku CSV, a przeglądać można pierwsze 10 000. Licznik nad tabelą podaje jednak pełną liczbę trafień dla ustawionych filtrów.
9. Czym różni się wersja pełna pliku od lekkiej?
Wersja lekka pomija trzy najdłuższe pola opisowe i pole zasięgu terytorialnego, dzięki czemu jest znacznie mniejsza. Do analiz dotyczących konkretnego państwa potrzebna jest wersja pełna.
10. Czy do analizy plików potrzebne jest programowanie?
Przy pliku zbiorczym tak, bo jeden dzień to ponad 20 mln wierszy. Pliki pojedynczych, mniejszych platform oraz próbkę z wyszukiwarki da się otworzyć w arkuszu kalkulacyjnym. Dla większych prac Komisja udostępnia pakiet dsa-tdb.
11. Czy baza pokazuje, ile zgłoszeń platformy odrzuciły?
Nie. Uzasadnienie powstaje tylko wtedy, gdy platforma nałożyła ograniczenie. Zgłoszenia, po których treść została bez zmian, nie trafiają do bazy.
12. Czy w bazie widać wynik odwołania od decyzji?
Nie. Informacje o środkach odwoławczych dostaje wyłącznie adresat decyzji. Baza nie rejestruje, czy treść przywrócono ani czy sprawa trafiła dalej.
13. Czy danym z bazy można ufać?
Można z nich korzystać, ale z ostrożnością. Dane wpisują same platformy, Komisja publikuje komunikaty o wykrytych błędach, a badacze opisywali niespójności. Każdą liczbę warto opatrzyć informacją o filtrach, okresie i dacie sprawdzenia.
14. Czy wolno publikować dane z bazy w artykule lub pracy dyplomowej?
Tak. Treści należące do Unii są udostępniane na licencji Creative Commons Uznanie autorstwa 4.0, więc wystarczy podać źródło i zaznaczyć zmiany. Komisja prosi o cytowanie bazy z identyfikatorem DOI.
15. Czy polskie serwisy też przesyłają uzasadnienia?
Na liście 375 platform znajdują się pojedyncze serwisy kojarzone z Polską, na przykład platforma ogłoszeniowa OLX. Wielu polskich portali, forów i serwisów z opiniami na liście nie ma.
16. Co oznacza decyzja w pełni zautomatyzowana?
To decyzja, w której cały proces oceny treści przebiegł bez udziału człowieka. Osobne pole informuje, czy automat wykrył treść, więc wykrycie i decyzja to dwie różne informacje.
17. Jak uzyskać dostęp do interfejsu badawczego?
Trzeba założyć konto EU Login i napisać do zespołu wsparcia Komisji z prośbą o token. Interfejs obejmuje ostatnie 6 miesięcy i ma limity: 1000 wierszy, 30 sekund i 5 MB na zapytanie.
Źródła
- Komisja Europejska, DG CONNECT, 2026: DSA transparency database - strona główna ze statystykami
- Komisja Europejska, DG CONNECT, 2026: Search for statements of reasons - wyszukiwarka uzasadnień
- Komisja Europejska, DG CONNECT, 2026: Dashboard - panel bazy przejrzystości DSA
- Komisja Europejska, DG CONNECT, 2026: Explore data overview - przegląd narzędzi
- Komisja Europejska, DG CONNECT, 2026: Data download - pliki dzienne
- Komisja Europejska, DG CONNECT, 2025: Data retention policy, wersja 2.0
- Komisja Europejska, DG CONNECT, 2025: Overview documentation - opis pól bazy
- Komisja Europejska, DG CONNECT, 2026: Research API - dokumentacja
- Komisja Europejska, DG CONNECT, 2026: Announcements - komunikaty o zmianach w bazie
- Komisja Europejska, DG CONNECT, 2024: Data license - licencja danych
- Komisja Europejska, 2025: DSA Transparency Database: Questions and Answers
- Komisja Europejska, 2026: W jaki sposób akt prawny o usługach cyfrowych zwiększa przejrzystość w internecie
- Komisja Europejska, code.europa.eu, 2024: dsa-tdb - dokumentacja pakietu
- arXiv, publikacja w ACM CSCW 2025, 2023: The DSA Transparency Database: Auditing Self-reported Moderation Actions by Social Media
- arXiv, publikacja w FAccT 2024, 2024: Automated Transparency: A Legal and Empirical Analysis of the Digital Services Act Transparency Database
A jakie zapytanie Wy zadaliście bazie? Napiszcie w komentarzu
Ciekawi nas, jakie filtry ustawiliście i czy wynik Was zaskoczył, na przykład przy wybranej platformie albo kategorii. Napiszcie też, jakiego zapytania o Polskę zabrakło w naszej tabeli, a sprawdzimy je i dopiszemy. Prosimy, by w komentarzach nie podawać nazwisk ani danych innych osób.
Komentarze
Wszystkie komentarze sprawdzamy przed publikacją. Emblemat przy nicku to ranga za wsparcie fundacji. Zdobądź swój emblemat